14. august 2026·Produktlansering

En ny generasjon norsk AI-deteksjon

NorBERT v3 er lansert. Høyere presisjon på sammensatte tekster, spesialtilpasset for bokmål og nynorsk, og med presis filtrering av usikkerhet.

To fagpersoner som gjennomgår en tekstanalyse sammen på en bærbar datamaskin

Hver uke analyserer studenter, lærere og fagskribenter tekster hos oss for å verifisere opprinnelse og skille menneskelig språk fra maskingenerert tekst. Tjenesten fungerer som et sentralt verktøy før innleveringer, i faglige vurderinger og for å sikre akademisk integritet.

I praksis handler utfordringen sjelden om tekster som er skrevet 100 % av en språkmodell. Det krevende skillet oppstår i sammensatte dokumenter: flere sider forfattet av studenten selv, der enkelte avsnitt eller formuleringer er generert av KI. Like viktig er problemet med at formelt, akademisk norsk ofte feilaktig flagges av internasjonale modeller som aldri har hatt et solid norsk treningsgrunnlag.

Fra i dag kjøres alle norske analyser på NorBERT v3. Modellen bygger videre på vår etablerte arkitektur, men er trent på et vesentlig større og mer balansert korpus. Den identifiserer presist maskingenererte elementer i overveiende menneskeskrevne dokumenter, og holder tvilstilfeller utenfor den endelige prosentscoren.
16X
Større treningsgrunnlag
V3
August 2026
99,41%
Macro F1

Ser setningene, ikke bare dokumentet

En samlet score på 40 % KI gir lite veiledning uten kontekst. Undervisere og studenter må vite nøyaktig hvilke partier som skiller seg ut. Ved å analysere teksten nedenfra kan modellen avdekke maskingenererte passasjer uten at helheten urettmessig mistenkeliggjøres.

  1. 01
    Token

    Hvert ord og delord analyseres for sannsynlighet av maskinopprinnelse.

  2. 02
    Setning

    Token-verdiene aggregeres i kontekst for å gi hver setning en presis score.

  3. 03
    Dokument

    Dokumentscoren beregnes ut fra entydige KI-setninger mot menneskeskrevne setninger. Usikre setninger utelates.

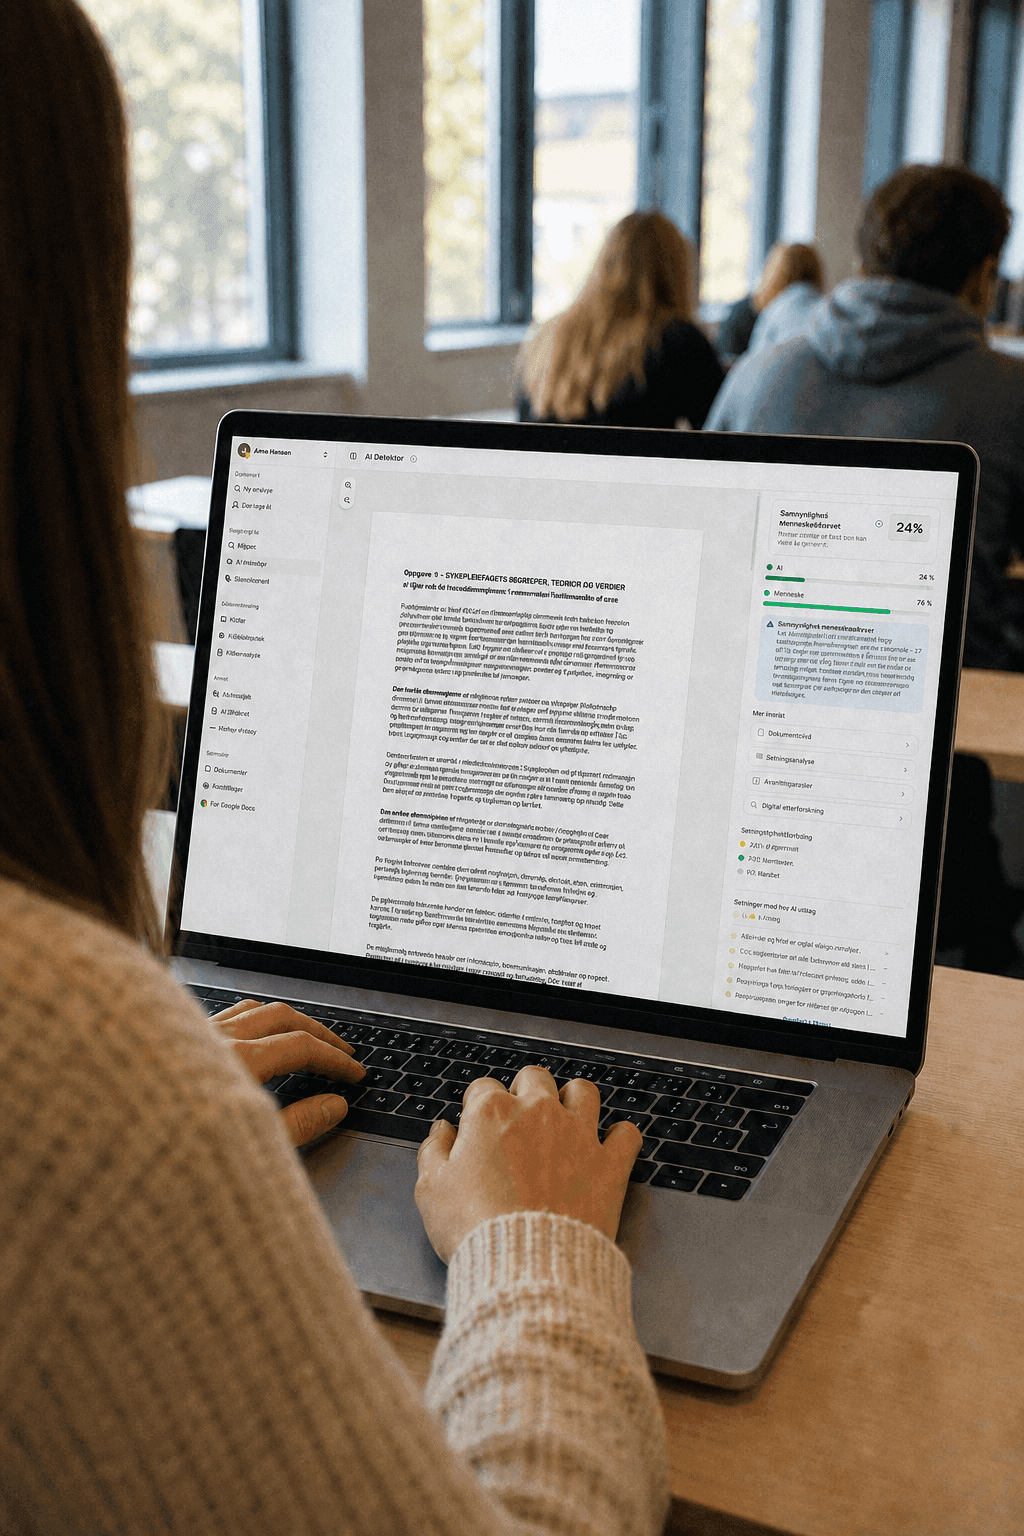
AI-detektoren viser analyse fra setning til dokument i et norsk oppgaveutkast
Oversikt over analyseflyten fra ordnivå til helhetlig dokumentvurdering.

Evalueringer

NorBERT v3 er vår nyeste produksjonsmodell for norsk språk (14. august 2026). Arkitekturen er optimalisert og trent på et vesentlig bredere og mer mangfoldig norsk datamateriale enn tidligere versjoner.

Treningsomfang

177 708
1 370 250
2 927 844
V1V2V3

Sammensetning

V2V3
Studentoppgaver1 000 000·1 249 997
Publiserte bøker10 000·1 000 000
Leksikon7 499·500 000
Studenteksamener64 923·330 659
Annet norsk sakprosa60 295·ca. 219 000

*Andre datasett er også matet inn i modellen

I utviklingen av v3 fokuserte vi målrettet på dokumenter med verifisert menneskelig opphav: tidligere eksamensoppgaver og studentarbeider produsert før 2020 — i perioden før ChatGPT og generative språkmodeller ble tilgjengelige. Dette sikrer et uovertruffent referansegrunnlag for å skille ekte menneskelig formspråk fra maskingenererte tekstmønstre.

NorBERT v3 vekter studentoppgaver, faglitteratur, leksikalske tekster og historiske studenteksamener tyngre enn andre datasett i treningsbasen.

Lab-tall

94,45 %
~98 %
99,41 %
V1V2V3

Ikke samme test, ikke produktnøyaktighet.

Slik beregnes prosentscoren

Endelig score = KI-setninger / (KI-setninger + menneskeskrevne setninger). Usikre setninger utelates fra beregningen for å unngå feilaktig forhøyede tall.

Token-nivåSetningsgjennomsnittDokumentandel

Ingen deteksjonsmodell kan garantere 100 % treffsikkerhet. Korte tekstutdrag, maskinoversatt innhold eller grundig bearbeidet KI-tekst kan påvirke resultatet. Analysen er ment som et veiledende beslutningsgrunnlag, ikke som et ugjendrivelig bevis.

Bygget for det norske språket

Norsk har en særegen setningsstruktur og syntaks som skiller seg vesentlig fra engelsk. Modeller trent utelukkende på internasjonale datasett flagger ofte formelt, saklig norsk som maskinskrevet — samtidig som de kan overse oversatt eller lett bearbeidet KI-tekst. NorBERT er spesialtrent for både bokmål og nynorsk. Når du analyserer en norsk tekst, behandles den utelukkende av denne modellen. Øvrige språk rutes til en spesialisert tredjepartsmodell.

Omfattende datagrunnlag

v3 er trent på et mangedoblet norsk korpus sammenlignet med første versjon — en økning på omtrent 16 ganger i datavolum.

Flere modellfamilier

Finjustert mot ledende modeller fra OpenAI, Gemini og Claude — verktøyene som faktisk benyttes i dag, ikke bare eldre tekstmønstre.

Sammensatte dokumenter

Identifiserer isolerte KI-setninger i et ellers selvstendig forfattet dokument, uten å gi urimelig utslag på helheten.

Presis usikkerhetshåndtering

Setninger i gråsonen ekskluderes fra den samlede prosenten, noe som gir et mer stabilt og pålitelig resultat.

Student som bruker en språkmodell på en bærbar i et klasserom

Trent på verktøyene studentene bruker

Presisjonen til en detektor avhenger direkte av variasjonen i treningsmaterialet. v3 er kontinuerlig evaluert og trent mot tekst generert av modellene under, med versjoner tilgjengelige per august 2026.

OpenAI
GPT-4o-mini, GPT-5.2, GPT-5.6
Gemini
Gemini 3 Flash
Claude
Claude Opus 4.5

Tydelige rammer og begrensninger

Ingen AI-detektor er ufeilbarlig. Svært korte tekstutdrag, direkte maskinoversatt materiale, omfattende omarbeidet tekst eller uvanlige fagsjangre kan føre til feilaktige utslag.

Formelt eller sterkt strukturert fagspråk forfattet av mennesker kan i enkelte tilfeller gi forhøyet sannsynlighet. Nye modellversjoner og utvikling i generative verktøy krever dessuten kontinuerlig oppdatering av deteksjonsgrunnlaget.

Prosentscoren er ment som et beslutningsstøtteverktøy. Formålet er å gi faglig innsikt og synliggjøre mønstre i teksten, ikke å felle en automatisk dom. Analysen bør alltid inngå som del av en helhetlig, faglig vurdering — aldri som et isolert bevis i juksesaker.

Prøv ut AI-detektoren i dag

NorBERT v3 er i full drift for både bokmål og nynorsk. Lim inn teksten og få umiddelbar innsikt på setningsnivå.